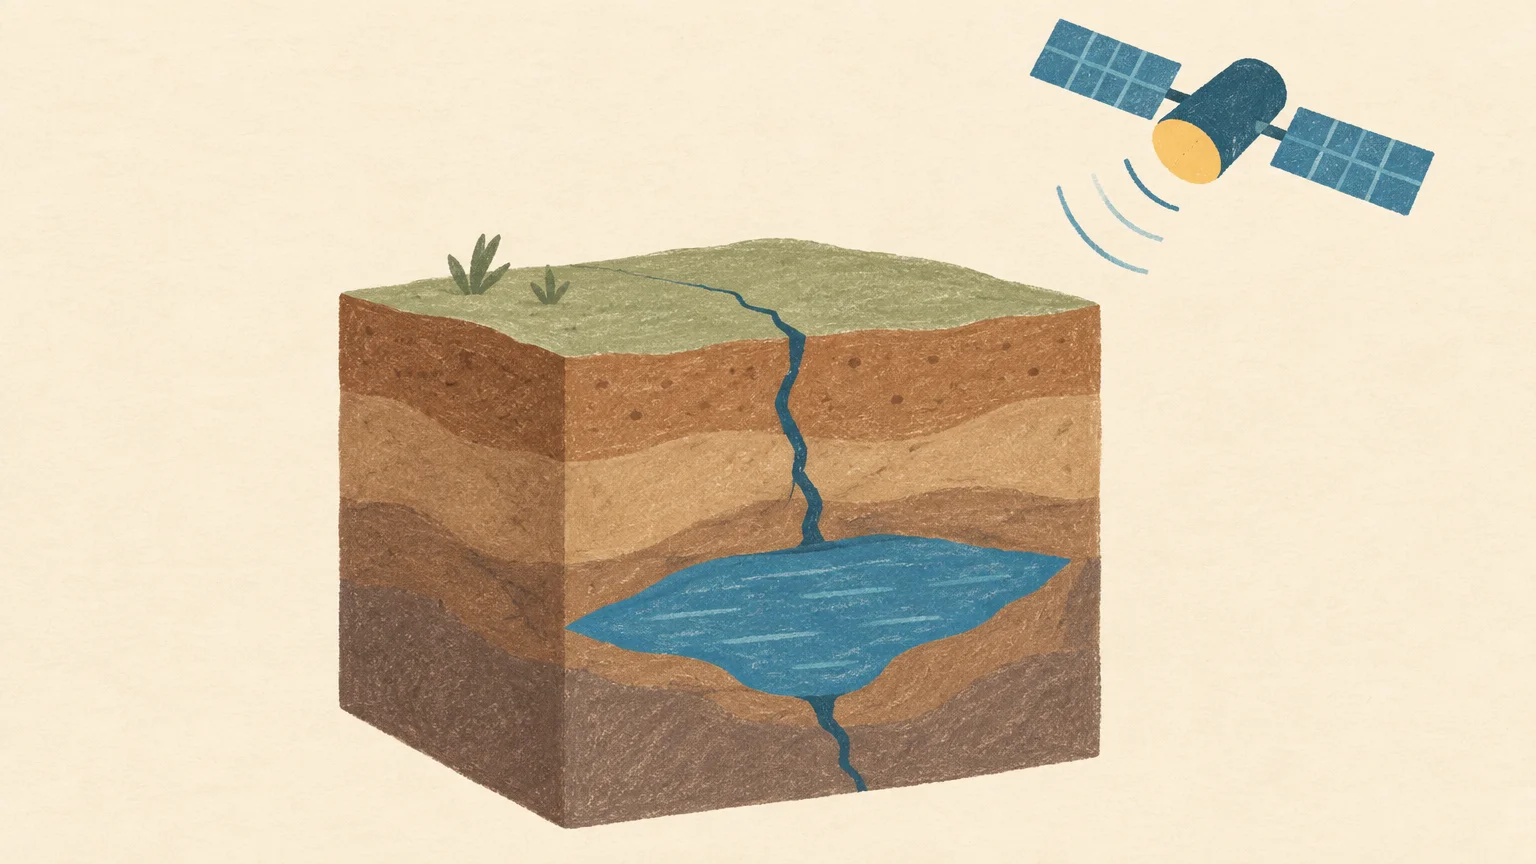
El satélite SWOT mide por primera vez cuánto cambia el agua de los ríos del mundo, y los modelos fallaban

El satélite SWOT, de la NASA y la agencia espacial francesa CNES, ha seguido por primera vez, mes a mes y durante un año entero, cuánto cambia el agua almacenada en los ríos de casi todo el planeta. En su primer ciclo de observación, de octubre de 2023 a septiembre de 2024, el volumen de los ríos que vigila osciló unos 313 kilómetros cúbicos, un 28 % menos que la estimación más baja de los modelos. El estudio se publicó en Nature el 4 de marzo de 2026.

Que la cifra sea menor que la de los modelos no significa que los ríos tengan menos agua. Significa que, por primera vez, hay una medición con la que comprobar cuánto se equivocan las simulaciones, y la respuesta es que bastante.

¿Qué mide exactamente SWOT?

SWOT no mide el volumen total de un río, sino cómo cambia. Su instrumento principal, el radar interferométrico en banda Ka (KaRIn), mide a la vez la anchura del río y la altura de su superficie, rebotando microondas en el agua en dos franjas de 50 kilómetros a cada lado del satélite, según el resumen de la NASA sobre el estudio. Con esos datos se calcula cuánto volumen gana o pierde cada tramo de un mes a otro.

Hasta ahora había que combinar instrumentos que medían la altura con estimaciones de anchura por satélite óptico o radar, o directamente recurrir a modelos. SWOT lo hace todo a la vez. El satélite se lanzó en diciembre de 2022 desde la base de Vandenberg, en California, con aportaciones de las agencias espaciales canadiense y británica. En wwwhatsnew contamos entonces que la NASA estaba a punto de lanzar SWOT para vigilar el agua de la Tierra.

El análisis usó casi 1,6 millones de observaciones de unos 127.000 tramos de río; la nota de Nature concreta 126.674.

¿Qué ríos cambian más a lo largo del año?

El Amazonas, con diferencia. Ganó y perdió más de 172 kilómetros cúbicos de agua en el periodo estudiado, más que cualquier otro río. La NASA lo traduce a otra escala: suficiente para llenar 68 millones de piscinas olímpicas.

En el Amazonas, el Misisipi, el Orinoco, el Yangtsé, el Ganges, el Mekong y el Yeniséi, el nivel del agua varía más de 10 metros entre su punto más alto y el más bajo del año, según la NASA y la nota de prensa de Nature. En el otro extremo está el Nilo, que solo osciló 8,5 kilómetros cúbicos, menos de lo esperado. La NASA apunta tres posibles causas: las presas río arriba, una sequía severa y las dificultades propias de un instrumento nuevo.

Por qué la cifra es menor que la de los modelos

La variación medida fue un 28 % inferior a la estimación más baja de los modelos hidrológicos. La NASA relaciona parte de esa diferencia con la sequía extrema que vivió la cuenca del Amazonas durante el periodo de observación: con menos agua entrando, hay menos que ganar y perder.

Pero la conclusión de los autores va más allá de un año seco. Según la Universidad Estatal de Ohio, cuyo equipo participó en el trabajo, la comparación indica que los modelos globales necesitan mejoras importantes en cómo representan la dinámica de ríos y aguas superficiales. Los propios autores reconocen que los datos son de la primera etapa de la misión y tienen incertidumbre, y que quedan huecos en zonas con hielo y en llanuras de inundación.

La forma de las orillas

El estudio tiene una segunda parte menos llamativa pero útil: mapas casi globales de la forma de los cauces activos. El título del artículo lo deja claro, «Wide-swath altimetry maps bank shapes and storage changes in global rivers». Una de las conclusiones es que ríos con caudales parecidos pueden tener formas muy distintas, algo que los modelos tienden a simplificar.

¿Cuánta agua hay en total en los ríos?

SWOT no lo dice, pero hay una estimación anterior del mismo grupo de la NASA. En abril de 2024, un estudio publicado en Nature Geoscience, con datos de 1980 a 2009 y unos 3 millones de tramos de río, calculó que los ríos del planeta almacenan de media unos 2.246 kilómetros cúbicos, y que el Amazonas concentra alrededor del 38 %, según el JPL.

Ese trabajo combinaba modelos con unas 1.000 estaciones de aforo. Sus autores ya anticipaban que SWOT serviría para contrastarlo. Los dos números no se pueden comparar directamente: uno es un volumen medio estimado con modelos para otra época y otra red de ríos, y el otro, una oscilación anual medida desde el espacio. Lo que sí tienen en común es el grupo que los firma y el objetivo, que es dejar de depender solo de simulaciones.

«Estamos empezando a resolver algunas de las preguntas realmente difíciles para las que se construyó SWOT», dijo Cédric David, que dirige el equipo de investigación de SWOT en el JPL. «Esto es solo el principio». Para Arnaud Cerbelaud, que codirigió el estudio, las implicaciones «van mucho más allá de la hidrología».

Mi lectura es que el valor de este estudio no está en el número, sino en que por fin existe un número medido. La gestión del agua y la predicción de inundaciones y sequías se apoyan en modelos que, como muestra SWOT, pueden desviarse bastante; los autores lo dicen explícitamente. Un solo año de datos, y además excepcionalmente seco en el Amazonas, no basta para rehacerlos, pero sí para dejar de tratarlos como verdad.

Lo prudente es esperar a varios ciclos anuales antes de sacar conclusiones sobre tendencias. Lo que sí se puede afirmar ya es que la observación por satélite está pasando de complementar los modelos a corregirlos, una tendencia que también vemos en la nueva generación de satélites de observación terrestre con IA a bordo.
BRP, el péptido que Stanford encontró con IA y que frena el apetito sin las náuseas de Ozempic (de momento, en animales)

Un equipo de Stanford Medicine encontró con ayuda de un algoritmo un péptido natural, el BRP, que en ratones y cerdos reduce el apetito, y en ratones la grasa corporal, sin los efectos secundarios digestivos típicos de la semaglutida (el principio activo de Ozempic y Wegovy). El estudio se publicó en Nature en 2025. Lo que conviene tener claro desde el principio: no se ha probado todavía en personas, y entre un buen resultado en animales y un fármaco hay muchos años y muchos fracasos posibles.

Aun así, el hallazgo tiene dos cosas que lo hacen interesante: cómo se encontró y por qué vía actúa. La explicación más completa está en la nota de Stanford Medicine sobre el péptido BRP, y la cobertura sigue llegando en 2026, como prueban los artículos de ScienceDaily de abril y julio de este año.

¿Qué es el BRP y de dónde sale?

Es un péptido de 12 aminoácidos que el propio cuerpo produce. Su nombre viene de la prohormona de la que procede, BRINP2.

Las prohormonas son proteínas que unas enzimas cortan en trozos más pequeños con función propia. El caso más famoso es el GLP-1, la hormona que imitan la semaglutida y el resto de fármacos de su familia. La enzima clave en ese proceso se llama prohormona convertasa 1/3 (PCSK1). Según el resumen del artículo en Nature, buena parte de los péptidos que genera esa enzima seguían sin caracterizar, y ahí es donde entra el algoritmo.

Cómo lo encontró la inteligencia artificial

El equipo, dirigido por la investigadora Katrin Svensson, creó una herramienta computacional llamada Peptide Predictor. Su trabajo fue revisar los cerca de 20.000 genes humanos que codifican proteínas y buscar en ellos los puntos donde la PCSK1 suele cortar.

El embudo es claro. De 20.000 genes salieron 373 prohormonas candidatas, que daban lugar a 2.683 péptidos posibles. De ellos, los investigadores eligieron 100 para probarlos en células neuronales cultivadas en el laboratorio. El BRP multiplicó por unas diez la actividad de esas células frente al control; el GLP-1, por unas tres.

«El algoritmo fue absolutamente clave para nuestros hallazgos», dijo Svensson. Conviene matizar qué tipo de IA es: no un modelo generativo que inventa moléculas, sino un sistema de predicción que acota la búsqueda para que el laboratorio pruebe 100 candidatos en lugar de miles. Es el mismo enfoque de cribado que vimos en DrugCLIP, la IA que convierte la búsqueda de fármacos en un motor de búsqueda molecular.

¿Qué efectos tuvo en los animales?

En ratones delgados y en minicerdos, una inyección antes de comer redujo la ingesta de la hora siguiente hasta un 50 %. En ratones obesos, tras 14 días de inyecciones diarias, los tratados perdieron de media unos 3 gramos, sobre todo grasa, mientras los del grupo control ganaron unos 3 gramos. Además, mejoraron su tolerancia a la glucosa y a la insulina.

Lo más llamativo es lo que no apareció. En las pruebas de comportamiento no hubo diferencias en movimiento, consumo de agua, ansiedad ni heces. Según Stanford, el BRP funcionó sin efectos asociados a la semaglutida como las náuseas, el estreñimiento o la pérdida significativa de masa muscular.

Para poner eso en perspectiva: en el ensayo STEP 1 de semaglutida en personas, publicado en el New England Journal of Medicine en 2021, el 44,2 % de los pacientes tuvo náuseas, frente al 17,4 % con placebo, según el resumen del Colegio Americano de Gastroenterología. En ese mismo ensayo, la pérdida de peso media a las 68 semanas fue del 14,9 %, frente al 2,4 % con placebo. Esa es la vara de medir, y el BRP está lejos de poder compararse con ella todavía.

Una vía distinta en el cerebro

Según los autores, el BRP activa la proteína FOS en el cerebro y actúa sobre todo en el hipotálamo, la zona que controla el apetito y el metabolismo. Y lo hace de forma independiente del receptor de GLP-1, de la leptina y del receptor de melanocortina 4. La semaglutida, en cambio, actúa sobre receptores del cerebro, del intestino y del páncreas, lo que explica parte de sus efectos más amplios.

Esa independencia es lo que hace del BRP algo más que «otro Ozempic»: si funciona por otra vía, podría servir a quien no tolera los fármacos actuales o combinarse con ellos. Pero son hipótesis; el receptor al que se une el BRP todavía no se ha identificado.

¿Cuándo podría llegar a personas?

No hay fecha. Según Stanford, Svensson cofundó la empresa Merrifield Therapeutics para llevar el péptido a ensayos clínicos «en un futuro próximo», y ella y la primera autora, Laetitia Coassolo, figuran como inventoras en las patentes del BRP. «Tenemos muchas ganas de saber si es seguro y eficaz en humanos», dijo Svensson.

Las coberturas de 2026 que hemos revisado no recogen ningún ensayo en marcha. Antes de eso, el equipo tiene deberes pendientes: identificar el receptor, mapear la cadena de señales y conseguir que el efecto dure más en el cuerpo para permitir una pauta de dosis más cómoda.

Mi lectura es que la noticia de verdad no es el péptido, sino el método. Un barrido computacional de los genes humanos ha encontrado una molécula que el cuerpo ya fabricaba y que nadie había caracterizado, y los autores sostienen que el mismo método puede descubrir otros péptidos bioactivos. Eso es más sólido que cualquier promesa sobre peso.

Lo discutible es el titular de «rival de Ozempic» con el que se difundió el estudio. Tres gramos en un ratón y menos comida durante una hora no son un tratamiento contra la obesidad, y un buen resultado en roedores no garantiza nada en personas. La biología del peso es tozuda, como recordábamos al hablar de los mecanismos con los que el cerebro defiende el peso corporal. Habrá que esperar a los primeros ensayos en personas para saber si el BRP es una alternativa o solo una buena historia.

PhoneBot: el humanoide de la UCLA que usa un móvil Android como cerebro y cuyo cuerpo cuesta unos 400 dólares

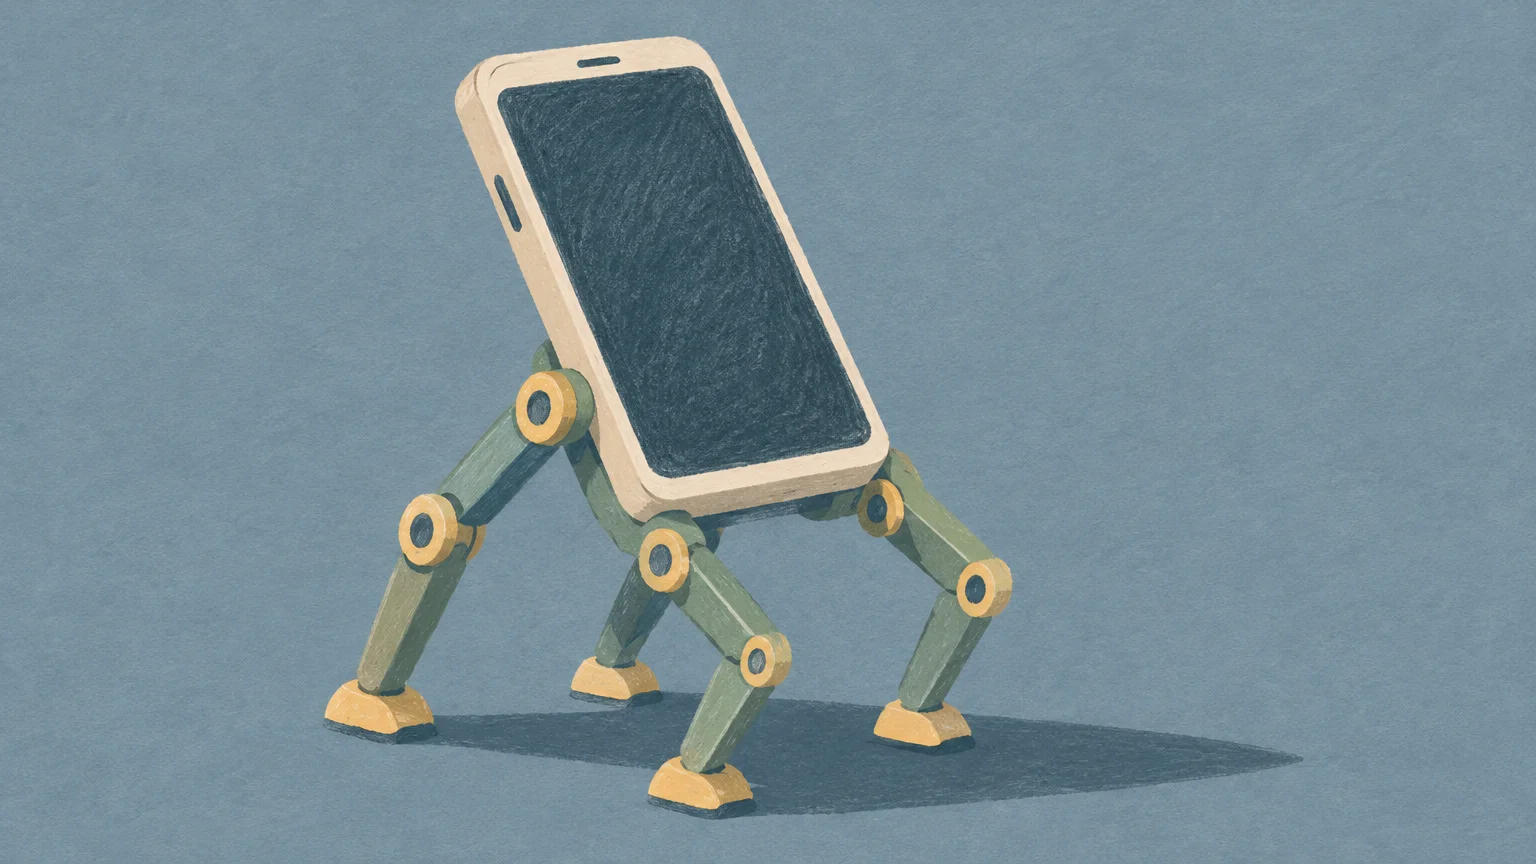
Un equipo de la UCLA ha construido un robot humanoide bípedo de 48 centímetros cuyo cerebro es un móvil Android normal y corriente. Se llama PhoneBot, pesa 1,8 kilos con el teléfono incluido y su cuerpo cuesta unos 400 dólares (≈ 350 euros), sin contar el móvil. Es hasta 35 veces más barato que otros humanoides pequeños de investigación.

El trabajo está descrito en un preprint publicado en arXiv el 6 de octubre de 2026, firmado por Ruochen Hou, Quanyou Wang, Daniel Koh y Dennis W. Hong, del Robotics and Mechanisms Laboratory (RoMeLa) de la UCLA. Es un preprint: todavía no ha pasado revisión por pares.

La idea es sencilla y por eso funciona: casi todo lo caro de un robot (sensores de movimiento, cámara, procesador, conectividad) ya lo llevas en el bolsillo.

Cómo funciona un robot que usa el móvil como cerebro

El teléfono va montado en el torso y hace de ojos, de oído del equilibrio y de cerebro. Su unidad de medida inercial (IMU) informa de la inclinación y la rotación; su cámara trasera ve; su procesador ejecuta la red neuronal que decide dónde poner cada articulación; y su pantalla táctil sirve como panel de control.

Lo que el móvil no hace es mover los motores directamente. Según el paper, envía las posiciones de las articulaciones por Wi-Fi a un pequeño ordenador de placa única instalado en el cuerpo, que las reenvía a los servos. Los autores explican que es una decisión deliberada para evitar las limitaciones de las conexiones por cable y para que la plataforma sea compatible con distintos teléfonos.

El cuerpo lleva 13 servomotores DYNAMIXEL XL430-W250-T, de 23,90 dólares cada uno: seis por pierna (cadera, rodilla y tobillo) y uno que gira el torso. Ese giro permite que la cámara siga a una persona sin que el robot tenga que mover los pies. Los motores son, según el propio paper, el principal coste de la plataforma.

La conversación tampoco corre entera en el teléfono. El reconocimiento de voz (whisper.cpp) y el modelo de lenguaje funcionan en un portátil cercano, al que el móvil se conecta por Wi-Fi, y la respuesta se reproduce con síntesis de voz por el altavoz del teléfono.

¿Por qué un humanoide de 400 dólares importa para la investigación?

Porque el precio es lo que hoy deja fuera a muchas aulas y laboratorios. La tabla comparativa del paper sitúa a PhoneBot frente a otros humanoides pequeños de investigación:

  • ROBOTIS OP3: 51 cm y 13.800 dólares.
  • BRUCE: 70 cm y 9.000 dólares.
  • ToddlerBot: 56 cm y 6.000 dólares.
  • Berkeley Humanoid Lite: 80 cm y 5.000 dólares.
  • HighTorque Mini Pi: 52 cm y 3.500 dólares.
  • PhoneBot: 48 cm y unos 400 dólares, sin móvil.

La comparación no es del todo justa, y conviene decirlo: casi todos los demás tienen más grados de libertad (entre 16 y 30, frente a los 13 de PhoneBot; solo el Mini Pi se queda en 12), y PhoneBot no tiene brazos. Pero el salto de precio es tan grande que cambia la pregunta. Ya no es «¿podemos permitirnos un humanoide?», sino «¿cuántos podemos montar?». Va en la misma línea que proyectos abiertos como HopeJR, el humanoide de código abierto por menos de 3.000 dólares, o Bridge, el humanoide de 88 centímetros de Zeroth, pero apretando todavía más el coste.

Los autores publican el diseño de hardware y el software como código abierto, con la web del proyecto en phonebot.dev, y lo orientan a educación, investigación y prototipado rápido.

¿Sirve cualquier móvil Android?

No está demostrado que sirva cualquiera, pero sí que valen móviles baratos o viejos. El equipo probó la aplicación en cuatro teléfonos: un Honor 9 de 2017 de segunda mano y tres móviles de prepago de entre 50 y 90 dólares (un moto g 2025, un Galaxy A16 5G y un moto g 2024).

Los cuatro ejecutaron las funciones básicas: lectura de la IMU a 200 Hz, comunicación con los motores, la red neuronal de locomoción, la visión y la interacción. La única excepción fue el mapeado con ARCore en el Honor 9, que no funcionó porque ese terminal de Huawei no tiene los servicios de Google en Estados Unidos.

Es una buena noticia para la segunda vida de los móviles que acumulamos en un cajón, una idea que en wwwhatsnew ya exploramos cuando hablamos de convertir tu viejo smartphone en el cerebro del hogar inteligente.

Cómo aprendió a andar

La marcha se entrenó por aprendizaje por refuerzo en simulación (MuJoCo/MJX), con un modelo que reproduce los límites reales de los servos: un par máximo de 1,4 N·m, su velocidad y la holgura de los engranajes. Así, lo que el robot aprende en el simulador es algo que sus motores pueden ejecutar de verdad. Un truco de «espejo» sagital, que intercambia los lados izquierdo y derecho durante el entrenamiento, mejoró la eficiencia y la simetría de los pasos.

En las pruebas físicas, PhoneBot anduvo, se levantó desde el suelo y siguió a una persona con la cámara. El paper reconoce sus límites sin rodeos: no tiene brazos, solo se ha entrenado en suelo plano y la poca fuerza de los servos limita la carga y los movimientos dinámicos. El trabajo futuro pasa por terreno irregular y brazos ligeros.

Mi lectura es que PhoneBot no va a competir con los humanoides industriales que vemos en fábricas, ni lo pretende. Su valor está en otra parte: demuestra que el hardware más caro de la robótica de investigación ya está fabricado en masa y metido en un bolsillo, y que lo que faltaba era el diseño para aprovecharlo.

Si el proyecto cumple lo que promete en código abierto, el humanoide de bajo coste deja de ser una pieza de laboratorio bien financiado y pasa a ser algo que un instituto puede montar con un presupuesto modesto y los móviles viejos de sus alumnos. Esa es la apuesta, y me parece la parte más interesante de todo el trabajo.

El MIT crea un hidrogel que respira: canales de aire que multiplican por diez el paso de oxígeno

Los hidrogeles tienen un problema que cualquiera que haya llevado un parche varios días conoce: no dejan respirar la piel. Un equipo del MIT dirigido por Xuanhe Zhao ha resuelto buena parte de ese problema metiendo diminutos canales de aire dentro del gel, y ha conseguido una permeabilidad al oxígeno unas diez veces mayor que la de un hidrogel convencional sin que pierda su blandura.

El trabajo se publicó en Nature en julio de 2026 con el título «Air-permeable hydrogels through viscoelastic phase separation of aerogels», y el MIT lo presentó el 8 de julio en un artículo de MIT News sobre el hidrogel transpirable. Es investigación de laboratorio con pruebas en voluntarios, no un producto a la venta.

Lo interesante es el truco que usan para conseguirlo y lo que abre para vendajes, sensores y wearables médicos que hoy no aguantan más de unos días pegados a la piel.

¿Por qué los hidrogeles no dejan pasar el aire?

Porque son, sobre todo, agua. Un hidrogel típico tiene alrededor de un 90 % de agua retenida en una red de polímeros, y gases como el oxígeno se disuelven y se difunden muy mal en el agua. «No puedes respirar a través de una gelatina», lo resume en MIT News Xiao-Yun Yan, que firma el estudio en primer lugar.

Eso tiene consecuencias prácticas. Un parche que no deja pasar el oxígeno ni el vapor de agua acumula humedad debajo, puede irritar la piel y empeora la señal de los sensores cuando sudas. Según el paper, las soluciones anteriores para hacerlos más transpirables eran frágiles o obligaban a sacrificar contenido de agua, por ejemplo por debajo del 50 % en volumen.

Los hidrogeles convencionales se quedan, por lo general, por debajo de 40 barrer de permeabilidad al oxígeno (el barrer es la unidad con la que se mide cuánto gas atraviesa un material). Un hidrogel de PVA estándar se queda en 15,5 barrer.

Cómo consiguen meter aire en un gel

La clave son unas partículas de aerogel de sílice, de unos 8 micrómetros de diámetro y un 90 % de porosidad. Son superhidrófobas, es decir, repelen el agua, así que funcionan como burbujas de aire en forma sólida.

El equipo añade una pequeña cantidad de esas partículas (un 2 % o un 4 % en peso) a la receta normal del hidrogel. Durante unas horas se produce una separación de fases viscoelástica, parecida a cuando el aceite y el agua se separan: el agua se concentra en bolsas y empuja las partículas de sílice hasta formar una red de túneles finos e interconectados. Después, el gel se entrecruza para fijar esa red de canales de aire.

El resultado es un hidrogel con un 70 % de agua que alcanza 185 barrer, el récord según los autores. El de PVA pasa de 15,5 a 153 barrer con el nuevo método. El paper añade que su transmisión de vapor de agua es entre 10 y 100 veces mayor que la de los parches de silicona y poliuretano, y que la técnica funciona con varias químicas distintas: alginato, agarosa, quitosano y gelatina.

Hay una demostración visual muy clara: a diferencia de los hidrogeles convencionales, el gel transpirable flota en el agua. En las pruebas, siguió flotando durante 10 días.

¿Aguanta el uso real?

Los datos de durabilidad son prometedores, aunque con una escala de pruebas todavía pequeña. Tras 10.000 ciclos de estiramiento al 20 %, la permeabilidad al aire cayó en torno a un 5 % y la rigidez (módulo de Young) bajó un 12,8 %. «Después de 10.000 ciclos, la caída de permeabilidad al oxígeno fue inferior al 5 %», explica Shucong Li, coautor del trabajo. Con un 2 % de aerogel, el material mantiene una rigidez parecida a la del hidrogel original, de unos 50 a 100 kilopascales.

Para probarlo en personas, el equipo usó el gel como adhesivo de un monitor de electrocardiograma inalámbrico. Durante 20 minutos de ejercicio, la señal se mantuvo estable, mientras que con un adhesivo de hidrogel comercial fluctuaba mucho. En pruebas de 10 días con entrenamientos habituales, la calidad de la señal se mantuvo y, según MIT News, no aparecieron ampollas ni rojeces al retirarlo.

Conviene leer esto con cautela. Según el propio paper, los grupos de prueba fueron reducidos: diez participantes en el estudio de comodidad del parche en el pecho y tres en las pruebas de electrocardiograma. Es una prueba de concepto sólida, no un ensayo clínico.

Qué puede cambiar en parches, sensores y vendajes

Los autores y el MIT apuntan a varias aplicaciones: vendajes y apósitos que duren más, mascarillas cosméticas y lentes de contacto, monitores de salud y también implantes. El paper muestra además versiones conductoras con aditivos, pensadas para electrodos de electrocardiograma más estables con el sudor. «Ahora que hemos añadido aire a los hidrogeles, la gente puede encontrar aplicaciones muy amplias», dice Zhao.

Encaja con otras líneas de investigación que buscan electrónica blanda compatible con el cuerpo, desde los transistores 3D de hidrogel que hablan el idioma de las células hasta la lámina de hidrogel inspirada en el pulpo que cambia de forma.

Mi lectura es que el avance importa más por lo que desbloquea que por lo que es. El cuello de botella de los wearables médicos no suele ser el sensor, sino el adhesivo: cuánto tiempo aguanta la piel debajo sin irritarse y cuánto dura la señal limpia. Un gel que respira ataca justo ese punto débil.

Lo que falta ahora es lo de siempre entre el laboratorio y la farmacia: pruebas con más personas, en pieles distintas y durante más tiempo, y un fabricante que lo produzca a escala y a buen precio. Hasta entonces, es una de las ideas más elegantes en materiales para la piel de los últimos tiempos, pendiente de demostrar que funciona fuera del MIT.

Flox Intelligence, la IA sueca que ahuyenta a la fauna de aeropuertos y vías de tren, busca 10 millones

Flox Intelligence fabrica dispositivos con IA que detectan animales cerca de pistas de aeropuerto, vías de tren o carreteras y los ahuyentan con sonidos adaptados a cada especie, sin dañarlos. La empresa nació en 2020 como spin-off del KTH Real Instituto de Tecnología de Estocolmo, tiene ya su sede en el estado de Nueva York y, según contó a TechCrunch el 13 de octubre, está abriendo una Serie A de 10 millones de dólares (≈ 8,7 millones de euros).

La ronda todavía no está cerrada. Lo que sí hay son unos 150 dispositivos instalados en Norteamérica, Europa y Australia, y un problema con un coste muy concreto.

¿Cómo funciona el dispositivo Edge?

Es una unidad autónoma, alimentada por batería, que procesa todo en el propio aparato y no en la nube. Se instala en postes, árboles u otras estructuras. Según TechCrunch, un sensor de movimiento despierta una cámara; modelos de IA que se ejecutan en el dispositivo identifican al animal, y el aparato reproduce un sonido apropiado para esa especie para alejarlo.

La clave está en que el sistema varía sus respuestas para que los animales no se acostumbren, que es el gran fallo de los espantapájaros acústicos clásicos. «Estaba convencida de que la respuesta no era un disuasorio más ruidoso», explicó a TechCrunch su cofundadora y consejera delegada, Sara Nozkova, que antes pasó 13 años en el sector del transporte y los vehículos autónomos.

Flox vende además una plataforma de software que muestra dónde están los dispositivos y qué detectan, y genera informes de cumplimiento normativo y de seguimiento de biodiversidad. Según la empresa, Edge ha registrado más de 60.000 eventos de fauna de 27 especies, una cifra que recoge Pulse 2.0 y que no ha sido auditada de forma independiente.

¿Por qué los aeropuertos son su mejor cliente potencial?

Porque el problema está medido y es caro. El último informe de la FAA sobre impactos con fauna, publicado en agosto de 2026, contabiliza 24.447 impactos notificados en la aviación civil estadounidense en 2025, un 9,3 % más que el año anterior. El 94,4 % fueron con aves.

El mismo informe estima para 2025 unas 74.372 horas de aviones parados y 391 millones de dólares en pérdidas, aunque advierte de que esas cifras pueden estar en la parte alta por cómo se notifican los costes. TechCrunch, citando a la FAA, da una media de unos 272 millones de dólares al año entre 1990 y 2025.

Flox ya tiene presencia en el sector. Entre sus clientes y socios figuran el aeropuerto internacional Gerald R. Ford y el Departamento de Agricultura de EE. UU., según Pulse 2.0. Antes, la empresa probó drones autónomos para despejar fauna en aeropuertos suecos (Malmö, Kiruna y Umeå) y preparó una demostración en un aeródromo del condado de San Mateo, en California, según el programa sueco Future Mobility.

Más allá de las pistas

El aeropuerto no es su único mercado. Los dispositivos también están en corredores de carretera y ferrocarril, parques nacionales, explotaciones agrícolas, minas y subestaciones eléctricas. Con Alstom tiene un acuerdo de tipo OEM: el fabricante paga una cuota anual por integrar el software de Flox en sus vehículos. Nozkova habla de una «IA física» que sale de la fábrica al exterior y sostiene que esas máquinas necesitarán una capa de «inteligencia de la naturaleza» que «casi nadie está construyendo».

Cuánto dinero ha levantado y cuánto factura

Unos 5 millones de dólares (≈ 4,4 millones de euros) entre presemilla y semilla, según TechCrunch. La secuencia, reconstruida con varias fuentes, es esta:

  • Verano de 2025: ronda semilla de casi 1 millón de dólares, liderada por Unconventional Ventures, con Norrsken Accelerate, según Tech.eu.
  • Febrero de 2026: ampliación Seed+ de 3 millones de dólares (≈ 2,6 millones de euros), liderada por Tilia Impact Ventures, con Satgana, GENIUS NY y J.O.S.S., según Pulse 2.0.
  • Mayo de 2026: gana el premio de 1 millón de dólares del acelerador GENIUS NY, que obliga a operar en el centro del estado de Nueva York durante al menos un año. Según CenterState CEO, Nozkova anunció que Syracuse sería su sede global; la I+D sigue en Estocolmo, según Techleap.
  • Octubre de 2026: abre la Serie A de 10 millones para pasar de 150 dispositivos a «varios miles».

Su modelo combina la venta inicial del hardware con una suscripción anual al software y la IA a partir del segundo año. Flox prevé cerrar 2026 con unos 1,5 millones de dólares de ingresos (≈ 1,3 millones de euros), según dijo a TechCrunch. La empresa es una de las finalistas de la competición Startup Battlefield 200 de TechCrunch Disrupt, que se celebra del 13 al 15 de octubre en San Francisco.

¿Qué la diferencia de la competencia?

No está sola. TechCrunch cita a Robin Radar, cuyo sistema Scarecrow emite llamadas de alarma específicas para cada especie de ave, y a iCHASE, que usa visión artificial y un láser móvil. Frente a ellos, Flox se presenta como un sistema para varias especies, mamíferos incluidos, pensado para lugares remotos con poca conectividad y que aprende de la experiencia para variar sus respuestas. Nozkova lo resume como «la verdad sobre el terreno de qué hace que un alce o un oso pardo se mueva de forma segura».

Mi lectura es que Flox tiene algo que muchas startups de IA no tienen: un problema caro, cuantificado por un regulador y con clientes que ya pagan por soluciones peores. Lo discutible está en la escala. Pasar de 150 a varios miles de dispositivos en entornos tan distintos como una pista de aterrizaje, una vía de tren o una mina es un reto de hardware, no solo de modelos, y las cifras de eficacia que maneja son todavía de la propia empresa.

Sería interesante ver datos independientes de algún aeropuerto: cuántos impactos había antes de instalar Edge y cuántos después. Hasta que lleguen, la apuesta tiene sentido, pero es eso, una apuesta. Para situarla en contexto, en wwwhatsnew hemos repasado otros usos de la IA en el campo, como la agricultura de precisión con sensores, drones e IA, y proyectos de conservación como la apuesta de Google por proteger la naturaleza con IA y su modelo SpeciesNet.

Siri ya pone Spotify sin que digas «en Spotify» en iOS 27, pero no en la Unión Europea

Con iOS 27, los usuarios de Spotify ya pueden pedirle música a Siri sin añadir «en Spotify» al final de cada orden: si la usas siempre con Spotify, Siri aprende que es tu aplicación preferida y le envía las peticiones de forma automática. Lo anunció Spotify el 13 de octubre de 2026, según TechCrunch. La mala noticia para el lector español: no funciona en la Unión Europea.

Tampoco funciona en cualquier iPhone ni en cualquier idioma. Los requisitos, recogidos en la página de ayuda de Spotify sobre Siri, dejan fuera a mucha gente.

¿Qué cambia exactamente?

Desaparece la coletilla. Hasta ahora, para que Siri no abriera otro servicio había que terminar la orden con «on Spotify» (o «en Spotify», según el idioma). Con la nueva integración basta con pedir la canción o el artista, siempre que Siri haya aprendido tu preferencia; por ahora, solo en inglés.

Según TechCrunch, la integración cubre canciones, álbumes, pódcast y audiolibros concretos, y también peticiones abiertas como «pon música para entrenar». Funcionan las funciones propias de Spotify, como «pon mi DJ», las recomendaciones personalizadas, retomar un pódcast, buscar en tu biblioteca o crear una Prompted Playlist, las listas generadas con IA.

La página de ayuda añade otras órdenes: guardar con «me gusta» en tu biblioteca, saltar canciones, pausar y cambiar el volumen. Además de en el iPhone, la integración funciona con AirPods, Apple Watch y CarPlay.

¿Qué necesito para usarlo?

Tres cosas, y ninguna es menor. Necesitas un iPhone 15 Pro o posterior con iOS 27, tener Apple Intelligence activado en Ajustes y usar Siri en inglés, que según la página de ayuda de Spotify es el único idioma compatible por ahora.

Cuando no se cumplen, sigue funcionando el método de siempre: Siri estándar, en cualquier idioma, en iPhone, iPad o iPod touch con iOS 14 o superior, añadiendo «en Spotify» a la orden. Es decir, nadie pierde nada; simplemente, la versión cómoda está reservada a los iPhone compatibles con Apple Intelligence.

¿Cómo aprende Siri? Spotify lo explica de forma muy escueta: cuanto más uses Spotify con Siri, más aprende tu preferencia. Si Siri se equivoca y abre otra aplicación, el consejo es volver a añadir «en Spotify» a la orden. El medio especializado RouteNote apunta además que la integración no cambia la configuración de música de todo el sistema y que, en algunas peticiones, puede seguir abriéndose Apple Music.

Por qué no llega a España

TechCrunch se limita a decir que la función está disponible en todo el mundo salvo en la UE, sin dar el motivo, y Spotify tampoco lo explica en su ayuda. Pero el contexto encaja con lo que Apple anunció en junio.

El 8 de junio de 2026, Apple comunicó en su sala de prensa que no podrá lanzar la nueva Siri con IA en la Unión Europea con iOS 27 e iPadOS 27. La compañía lo atribuye a la Ley de Mercados Digitales (DMA): según Apple, los reguladores le exigen dar a cualquier asistente acceso amplio a datos privados y control de otras aplicaciones sin las salvaguardas que considera necesarias, y rechazaron su propuesta de un intermediario llamado «Trusted System Agent».

«Nos decepciona profundamente que nuestros usuarios de la UE no tengan Siri con IA en el iPhone ni en el iPad», dijo Craig Federighi. Apple no tiene calendario para su llegada. Como la integración de Spotify exige Apple Intelligence en Siri, la conexión parece directa, aunque ninguna de las dos empresas la ha confirmado de forma explícita para esta función.

Conviene recordar que esa es la versión de Apple de un conflicto regulatorio con Bruselas. Mientras se resuelve, los usuarios europeos se quedan en medio.

Un problema que viene de iOS 14.5

La idea no es nueva. En 2021, con iOS 14.5, Apple ya introdujo que Siri «aprendiera» qué aplicación de audio preferías, como explicaba TechRadar. No era un ajuste para elegir aplicación por defecto: Siri preguntaba la primera vez y luego intentaba recordar la elección.

En la práctica funcionaba regular. En las pruebas de TechRadar con Spotify, Siri volvía a Apple Music tras unas cuantas peticiones, y había que insistir para fijar la preferencia.

Lo que cambia ahora es que Spotify lo presenta como integración oficial con la nueva Siri y con sus funciones exclusivas, como el DJ o las listas con IA. Si te interesa cómo funcionan esas recomendaciones, explicamos cómo los algoritmos de Spotify y Apple Music seleccionan tu música.

Mi lectura es que, para Spotify, esta es una victoria de las pequeñas pero significativas. Que el asistente de voz del iPhone deje de tirar por inercia hacia Apple Music es una mejora real para quien paga Spotify, aunque llega por la vía del aprendizaje de Siri, no por un ajuste que el usuario pueda fijar. Esa diferencia importa: depende de que Siri acierte, y la experiencia de 2021 invita a la prudencia hasta ver cómo se comporta en el día a día.

Lo paradójico es el mapa. La DMA nació para abrir las plataformas a terceros, y la UE es precisamente donde Spotify no podrá estrenar esta integración. Para quien esté en España, la única recomendación útil es la de siempre: seguir diciendo «en Spotify». Y si te preocupa qué oye exactamente el asistente cuando le hablas, repasamos cuánto saben Alexa, Google y Siri de lo que dices y cómo limitarlo.

Perseverance bate el récord de distancia total recorrida en otro mundo: 45,22 km en Marte

El rover Perseverance de la NASA es ya el vehículo que más distancia ha recorrido sobre la superficie de otro mundo. El 11 de octubre de 2026, en su sol (día marciano) 2.006, alcanzó los 45,22 kilómetros acumulados y dejó atrás los 45,16 km de Opportunity, el anterior plusmarquista.

Lo anunció el Jet Propulsion Laboratory de la NASA el 12 de octubre en su nota sobre el récord de distancia total de Perseverance. Conviene precisarlo: es un récord de distancia total a lo largo de la misión, no de la distancia recorrida en un solo día.

Y lo más llamativo no es la cifra, sino cómo la ha conseguido: conduciendo casi siempre solo.

¿Qué récord ha batido exactamente Perseverance?

El de distancia total recorrida por un vehículo fuera de la Tierra. Perseverance ha sumado 45,22 km desde que aterrizó en el cráter Jezero el 18 de febrero de 2021, frente a los 45,16 km que Opportunity acumuló en casi 15 años de misión. Perseverance lo ha hecho en unos cinco años y medio.

La NASA aprovecha para repasar la tabla de los grandes conductores fuera de la Tierra:

  • Perseverance (Marte): 45,22 km.
  • Opportunity (Marte, 2004-2018): 45,16 km.
  • Lunojod 2 (Luna, Unión Soviética, 1973): 39 km.
  • Curiosity (Marte, en activo): más de 38,07 km.
  • Vehículo lunar del Apolo 17 (1972), conducido por Gene Cernan y Harrison Schmitt: 35,7 km.
  • Spirit (Marte): 7,7 km.

El día del récord, el rover hizo un trayecto de 91,31 metros. No fue una jornada espectacular, solo la que le bastó para cruzar la línea.

¿Cómo ha conducido tanto en tan poco tiempo?

Gracias a la autonomía. Perseverance ha recorrido más del 90 % de su distancia total con AutoNav, el sistema que le permite cartografiar los obstáculos mientras avanza y trazar su propio camino entre los puntos de paso que fijan los planificadores desde la Tierra. La primera versión de AutoNav, la de Spirit y Opportunity, solo se usó en torno al 5 % de sus trayectos.

La diferencia está en el cálculo. Según el JPL, Perseverance evalúa 600.000 puntos de medida cada vez que analiza el terreno; Sojourner, el primer rover marciano, usaba 20. Eso le permite recorrer hasta 412 metros en un solo sol a su velocidad máxima, que en suelo llano y firme no llega a los 152 metros por hora, según la ficha técnica de los componentes del rover.

«La misión original no pedía más de 12,4 millas de conducción», recuerda Steven Lee, jefe de proyecto de Curiosity y Perseverance en el JPL. Esas 12,4 millas son unos 20 km: Perseverance ya ha recorrido más del doble. Mark Maimone, subjefe del equipo de operaciones robóticas del rover, lo resume así: «Con autonomía para simplemente avanzar, Perseverance conduce mejor que el que aterrizó».

¿Qué hay detrás de tanto kilómetro?

La distancia no es un fin en sí misma: sirve para llegar a las rocas que interesan. Perseverance ha recogido 29 muestras de roca y regolito en el fondo del cráter, en un antiguo abanico deltaico y en el borde de Jezero, dentro de su objetivo de buscar señales de vida microbiana antigua.

Ahora se dirige a una zona llamada Idubi, en la región de Lac de Charmes, junto al borde occidental del cráter, donde el equipo espera encontrar restos de antiguos sistemas hidrotermales. La NASA ha aprobado la primera extensión de la misión, que empezó en octubre y llega aproximadamente hasta finales de 2028, con un objetivo posterior hacia el sur: Rainbow Falls, un bloque de corteza antigua de unos 100 metros de ancho.

Un detalle técnico que explica por qué puede seguir en marcha: Perseverance no depende de paneles solares, sino de un generador termoeléctrico de radioisótopos (MMRTG) que convierte en electricidad el calor de la desintegración del plutonio-238, con una vida operativa prevista de 14 años. Es una de las tecnologías que nos están acercando al sueño de llegar a Marte. Mientras tanto, su veterano compañero sigue haciendo ciencia en otro cráter, como cuando Curiosity encontró un campo de texturas en panal en Marte.

Mi lectura es que el titular del récord se queda corto. Lo relevante no es que un robot haya superado a otro por 60 metros, sino que en más del 90 % de esos 45 km ha sido el propio rover el que ha evaluado el terreno y trazado su camino. Esa autonomía es la que hará viable explorar más terreno sin que cada metro dependa de una orden enviada desde la Tierra.

La siguiente pregunta es cuánto puede durar. Con la extensión aprobada hasta 2028 y un generador pensado para 14 años, Perseverance tiene margen para dejar el listón muy alto para la próxima generación de rovers.

El Reino Unido usa IA frontera contra sus propias vulnerabilidades: 407 fallos en un mes por 13.000 libras

El Gobierno británico ya ha usado modelos de IA frontera para auditar su propio código y la factura cabe en una hoja de cálculo: 407 hallazgos en nueve organizaciones públicas, en un mes y con 13.000 libras en tokens. Ese piloto, documentado por el GC3 en un caso de estudio publicado en GOV.UK, es ahora la base del paquete de ciberseguridad que el ministro de Inteligencia Artificial, Kanishka Narayan, presentó el 12 de octubre de 2026.

La cifra llamativa no es la de vulnerabilidades. Es lo barato que ha salido encontrarlas y lo que el propio informe admite sobre el cuello de botella real, que no está en la máquina sino en las personas que tienen que revisar lo que la máquina encuentra.

¿Qué hizo exactamente el GC3 con los modelos de IA?

Organizó una serie de hackatones semanales y presenciales en los que equipos con acceso a modelos frontera escanearon repositorios de código público de la administración. El Government Cyber Coordination Centre (GC3) es una colaboración entre el National Cyber Security Centre (NCSC) y el Departamento de Ciencia, Innovación y Tecnología, y trabajó con especialistas del AI Security Institute (AISI).

En lugar de imponer un método, el GC3 dio acceso a los modelos y dejó que cada equipo construyera sus herramientas. Salieron tres enfoques distintos:

  • Una cadena de agentes en seis etapas (triaje, validación, auditoría, rastreo, juez y resumen), con escalado manual a una persona del equipo.
  • Escáneres clásicos como Gitleaks, Trivy, Semgrep y Hadolint alimentando a los modelos, que después encadenaban rutas de ataque y filtraban resultados.
  • Cinco Claude Skills especializadas, construidas a partir de una auditoría de cientos de servicios.

Es un detalle relevante: ninguno de los tres equipos se limitó a pegar código en un chat. Todos montaron una arquitectura alrededor del modelo.

¿Qué encontraron y qué tan grave era?

Los 407 hallazgos incluyen debilidades críticas que permitían saltarse la autenticación, exponer datos o ejecutar código en remoto. Según el caso de estudio, todas las críticas se han corregido y no hay indicios de que nadie las explotara antes.

Algunas ya estaban mitigadas por otros controles; otras eran desconocidas. El ejemplo más grave que detalla el GC3 es un fallo en GitHub Actions: cualquier usuario externo podía publicar un comentario con una estructura concreta en una pull request abierta y disparar la ejecución de código arbitrario en el runner. Desde ahí, los secretos y tokens quedaban al alcance, con riesgo de un compromiso más amplio del repositorio.

El informe destaca además algo que los escáneres tradicionales no hacían: los modelos fueron capaces de seguir una vulnerabilidad a través de los límites entre servicios, que es justo donde suelen esconderse los fallos que nadie revisa porque cada equipo cree que es responsabilidad del otro.

El coste total fue de 13.000 libras en tokens, unos 17.467 dólares según el cálculo de Infosecurity Magazine (≈ 15.200 euros al tipo orientativo de octubre). Repartido entre nueve organizaciones y un mes de trabajo, sale a menos de 1.500 libras por organización en consumo de modelo, sin contar las horas de los especialistas, que el informe no cuantifica.

Lo que el informe reconoce y la nota de prensa no subraya

La parte más útil del caso de estudio son sus lecciones, y no todas son triunfalistas. La primera: la arquitectura importa más que el modelo. Los mejores resultados llegaron con modelos frontera usados como componentes muy acotados dentro de un flujo estructurado, con revisión humana en el escalado.

La segunda es todavía más interesante para quien esté comprando herramientas: con la arquitectura adecuada, muchos modelos frontera y casi frontera rindieron de forma parecida. El GC3 menciona como ejemplos recientes Claude Mythos y GPT-5.5, y el AISI advierte de que las puntuaciones en benchmarks no reflejan necesariamente la capacidad de encontrar y arreglar vulnerabilidades reales.

La tercera es el aviso que debería leer cualquier responsable de seguridad: los agentes generan candidatos a vulnerabilidad más rápido de lo que las personas pueden validarlos. El propio documento lo resume con una frase que podría colgarse en cualquier oficina de un CISO: encontrar no es lo mismo que arreglar. Priorizar, revisar y generar parches tiene que encajar en procesos humanos que ya están saturados.

Si la IA multiplica los hallazgos pero el equipo que los corrige sigue siendo el mismo, el resultado puede ser una cola más larga, no un sistema más seguro.

¿Qué anunció Narayan el 12 de octubre?

Un paquete de medidas que convierte el piloto en política. En un discurso en el Imperial College de Londres, Narayan dijo que quiere que Gran Bretaña sea «uno de los países más difíciles del mundo de atacar usando inteligencia artificial».

Los puntos concretos del discurso:

  • Dos pilotos del Gobierno han ayudado a identificar y corregir más de mil vulnerabilidades con IA frontera.
  • Un servicio central de monitorización ha reducido el tiempo para corregir debilidades de 50 días a 8.
  • Narayan, el ministro de ciberseguridad del DCMS y el ministro de Seguridad liderarán el uso «urgente» de IA frontera para buscar fallos en sistemas del Estado.
  • El Gobierno trabajará con el Parlamento para reforzar la Cyber Security and Resilience Bill frente a amenazas impulsadas por IA y riesgos de pérdida de control, incluida la notificación de incidentes graves y de casi-incidentes.
  • El DCMS, el NCSC y el AISI desarrollarán formas de contener incidentes con IA agéntica.
  • La IA será un eje de la presidencia británica del G20 el año que viene.

Hay un matiz que conviene no perder. The Next Web señala que el Gobierno habla de más de mil vulnerabilidades en dos pilotos, pero el caso de estudio publicado solo documenta uno, el de los 407 hallazgos. El resto de la cifra, de momento, hay que creérsela.

Narayan también tuvo un mensaje para los laboratorios: escuchad a vuestros científicos cuando avisen de peligros graves y, «si no podéis controlar adecuadamente los riesgos, no lancéis el sistema». Es una frase fácil de aplaudir y difícil de hacer cumplir desde un país que no aloja a los principales desarrolladores de modelos frontera.

¿Por qué importa fuera del Reino Unido?

Porque aquí un gobierno publica coste, método y límites de usar IA en ciberdefensa real, no en una demo. El debate sobre si estos modelos ayudan más a atacar o a defender suele moverse entre anuncios de empresa, como el agente Aardvark de OpenAI para detectar y corregir vulnerabilidades, e informes de amenazas que describen el lado contrario, como el que alertaba de que la carrera de los agentes de IA ha creado un caldo de cultivo para el cibercrimen.

El caso del GC3 aporta datos donde había sobre todo promesas. Y el siguiente paso ya está fijado: una segunda fase con más departamentos y más modelos que pasará del código público a los sistemas cerrados de la administración, un terreno que el caso de estudio todavía no ha medido.

Mi lectura es que el Reino Unido ha acertado en el orden: primero medir con su propio código, luego legislar. Lo discutible es la cifra redonda de «más de mil» sin un segundo informe que la respalde, y la tentación de vender la IA como acelerador cuando el propio GC3 dice que el freno está en la capacidad humana de revisar.

Si la segunda fase llega a sistemas cerrados con el mismo nivel de transparencia sobre costes y límites, este documento puede acabar siendo la plantilla que otros gobiernos copien. Si se queda en titulares de miles de vulnerabilidades, será otro anuncio más.

Meta Muse Wonder y Wonder Full: Meta vuelve a la élite de la IA, pero ya no abre sus mejores modelos

Meta ya tiene un modelo en la parte alta de las clasificaciones independientes, pero no lo vas a poder descargar. Muse Wonder y Muse Wonder Full, presentados el 12 de octubre de 2026, son modelos cerrados: el primero se usa por API y el segundo solo dentro de la suscripción Muse Code. El único modelo de la familia Muse con pesos abiertos sigue siendo Muse Glimmer.

Lo cuenta Meta en el anuncio oficial de Muse Wonder en su blog de investigación, donde los define como sus modelos más capaces para tareas agénticas personales y profesionales. La noticia tiene dos lecturas: Meta vuelve a competir arriba y, a la vez, se aleja un poco más del discurso abierto que construyó con Llama.

¿Dónde queda Muse Wonder frente a sus rivales?

En el Artificial Analysis Intelligence Index, una de las referencias independientes más seguidas, Muse Wonder Full marca 56 puntos y ocupa el cuarto puesto. Muse Wonder se queda en 52, en el décimo puesto y empatado con otros tres modelos.

Por encima de Wonder Full solo está Claude Opus 5.5, que lidera con 58; Claude Sonnet 5.5 empata con él a 56. Por debajo quedan Claude Fable 5.1 y GPT-6 Astra, ambos con 53 en su configuración máxima, según la clasificación de modelos de Artificial Analysis.

Hay un matiz importante. Para llegar a esos 56 puntos, Wonder Full consumió unos 140 millones de tokens de salida, frente a una mediana de 88 millones. Dicho de otra forma: piensa mucho y en voz alta, y eso se paga en tiempo y en dinero cuando lo usas de verdad.

En cuanto a los benchmarks propios, Meta habla de resultados punteros en pruebas de agentes, memoria y programación, como el benchmark legal de Harvey (LAB), FocusBench o SWE-Marathon, pero su post no incluye cifras en el texto. TechCrunch recoge que, según Meta, Wonder supera a Fable, Opus y Astra en MemoryBench. Son datos de la propia empresa y Meta reconoce que el informe de seguridad completo llegará «pronto».

Qué son Active Memory y Active Focus

Meta vende Wonder por dos funciones con nombre propio. Active Memory conserva contexto importante sobre el usuario entre conversaciones y recupera los detalles relevantes para la tarea en curso. La investigadora Kavya Kopparapu lo resumió en el vídeo de lanzamiento: el equipo se esforzó para que el modelo «recuerde lo que es importante para ti».

Active Focus es otra cosa y conviene describirlo bien. Según Meta, define cómo el modelo sigue trabajando hacia un objetivo difícil: prueba enfoques alternativos, sortea bloqueos y se adapta a información nueva. También pide aclaraciones cuando las necesita y consulta antes de dar pasos importantes. No es un modo de concentración para el usuario, sino una forma de persistencia del agente con frenos incorporados.

Las dos piezas apuntan al mismo sitio: el asistente que Meta quiere desplegar en Muse, su producto de consumo, donde Wonder llegará primero a los suscriptores. La empresa lo presenta como «un gran salto hacia la superinteligencia personal».

¿Cuánto cuesta usar Wonder y Wonder Full?

Por API, Muse Wonder cuesta 4 dólares por millón de tokens de entrada (≈ 3,48 euros) y 20 dólares por millón de salida (≈ 17,40 euros), con la entrada en caché a 0,20 dólares (≈ 0,17 euros). Es la misma tarifa que Claude Opus 5.5. Artificial Analysis calcula un coste medio de 4,52 dólares por tarea de su índice (≈ 3,93 euros).

Wonder Full no tiene API. Solo se usa dentro de Muse Code, que tiene cuatro planes según la página de ayuda de Muse Code:

  • Everyday Usage: 5 dólares al mes (≈ 4,35 euros).
  • High Usage: 15 dólares al mes (≈ 13,05 euros).
  • Power Usage: 50 dólares al mes (≈ 43,50 euros), el primero que incluye Wonder Full.
  • Maximum Usage: 200 dólares al mes (≈ 174 euros).

Las conversiones son orientativas; Meta indica que los beneficios y la disponibilidad varían por región y se muestran antes de suscribirse.

El detalle que más importa: el modo Contributor

Las suscripciones de Muse Code llegan con el modo Contributor activado por defecto. A cambio de más uso, Meta puede entrenar sus modelos con tus prompts, tu código, tus archivos, el contexto y las respuestas que recibes.

Se puede desactivar en cualquier momento y, según Meta, desde entonces «tu contenido futuro» no se usa para entrenar. La documentación no aclara qué ocurre con lo enviado antes de desactivarlo. Las cuentas con retención cero de datos no pueden usar este modo. En la API de Wonder, el contenido estándar no se usa para entrenar.

Para un desarrollador que trabaja con código de cliente, esto no es un detalle de letra pequeña: es la primera decisión que tiene que tomar al darse de alta. Y el diseño de la oferta, con más uso si cedes datos, empuja en una dirección muy concreta.

¿Por qué Meta ya no abre sus mejores modelos?

Porque su estrategia ha cambiado desde Llama. Glimmer, analizado por Artificial Analysis el 10 de agosto de 2026, es un modelo de 30.000 millones de parámetros bajo licencia Apache 2.0, el primero de Meta con esa licencia, según Artificial Analysis. Lo más capaz se queda en casa.

No es un giro que llegue de la nada. Zuckerberg ya reconoció en septiembre que Meta calculó mal con Llama 4 y que los laboratorios que retienen modelos le parecen «bastante peligrosos», una frase que hoy suena distinta. Y el viejo debate sobre si Llama era realmente código abierto queda casi resuelto por la vía práctica: la frontera de Meta ya ni siquiera aspira a ser abierta.

Los modelos se entrenaron en Prometheus, el centro de datos de Meta en Ohio, y son el primer lanzamiento frontera desde que Alexandr Wang reorganizó la IA de la compañía en agosto de 2025.

Mi lectura: Wonder es un regreso creíble a la élite, con un cuarto puesto en una clasificación independiente. Pero el producto que lo acompaña dice más que el benchmark. Wonder Full solo en suscripción, datos de entrenamiento activados por defecto y pesos cerrados describen una empresa que ha decidido competir como OpenAI y Anthropic, no como alternativa a ellas.

La pregunta que queda abierta es si los desarrolladores que llegaron a Meta por Llama aceptarán ese cambio de trato. Con un precio idéntico al de Opus 5.5 y un rendimiento algo inferior en el índice, Wonder tendrá que ganarse a los usuarios con memoria y agentes, no con apertura.

WhatsApp prueba los mensajes programados en Android: hasta dos semanas y aunque el móvil esté sin conexión

WhatsApp ha empezado a probar los mensajes programados en su beta para Android. La función, detectada por WABetaInfo en la versión 2.26.40.7, permite dejar preparado un texto, un enlace, una foto o un vídeo para que se envíe solo, entre 10 minutos y dos semanas después, incluso si el móvil está sin conexión en ese momento.

De momento solo llega a una parte de los probadores de la beta, y WABetaInfo espera que se amplíe en las próximas semanas. Es una de esas funciones que otras aplicaciones de mensajería tienen desde hace años, y por eso lo interesante no es tanto que llegue como la forma en que WhatsApp ha decidido resolverla.

¿Cómo se programa un mensaje en WhatsApp?

Se escribe el mensaje y se mantiene pulsado el botón de enviar. Aparece una hoja inferior en la que eliges el día y la hora de entrega, y a partir de ahí WhatsApp se encarga del envío.

Con fotos y vídeos el gesto es el mismo: eliges el archivo en la galería y mantienes pulsado enviar. Hay un límite claro: un solo elemento multimedia por mensaje programado. También funciona desde el editor de dibujo, así que puedes retocar una imagen o añadirle un pie de foto antes de dejarla en cola.

Los márgenes son estos:

  • Mínimo: 10 minutos desde la hora actual.
  • Máximo: dos semanas por delante.
  • Contenido: texto, enlaces, fotos y vídeos.
  • Chats: individuales y de grupo.

¿Qué pasa si tengo el móvil apagado a la hora del envío?

Según WABetaInfo, el mensaje se entrega a la hora elegida aunque la aplicación esté cerrada o el dispositivo esté sin conexión. Business Today, que cita a WABetaInfo, va más allá y dice que también funciona con el teléfono apagado, algo que el texto de WABetaInfo no menciona.

Ese es el detalle técnico más relevante de toda la función, y también el que queda menos explicado. WABetaInfo asegura que los mensajes programados son compatibles con el cifrado de extremo a extremo, pero no detalla dónde espera el mensaje hasta su hora ni cómo se gestiona esa cola. Para una aplicación que basa su marca en la privacidad, es la pregunta que Meta tendrá que contestar cuando la función salga de la beta.

Las reglas que WABetaInfo ya ha aclarado

Buena parte de las dudas habituales sobre esta función ya tienen respuesta en la información publicada:

  • Dónde se gestionan: en una sección propia dentro de la pantalla de información del chat, donde puedes ver los mensajes pendientes, gestionarlos y borrarlos antes de que se envíen.
  • Qué ve el destinatario: nada especial. No sabe que el mensaje estaba programado y no recibe ningún aviso si lo borras antes de tiempo.
  • Grupos: el mensaje solo llega a quienes eran miembros cuando lo programaste. Si alguien entra después, no lo recibe.
  • Compatibilidad: el destinatario no necesita tener la función para recibir un mensaje programado.

La regla de los grupos es la más fina. Evita que un mensaje pensado para un grupo concreto acabe en manos de alguien que se unió más tarde, algo especialmente útil en grupos de trabajo o de comunidades con altas y bajas frecuentes.

¿Por qué ha tardado tanto?

No hay explicación oficial, pero el calendario de la beta muestra un desarrollo largo. Y no es una función nueva en el sector: Telegram la estrenó en septiembre de 2019, con el mismo gesto de mantener pulsado el botón de enviar.

En WhatsApp el proceso ha sido largo. WABetaInfo vio el primer rastro en la beta 2.26.8.11, en febrero de 2026, cuando todavía no estaba disponible para probar y la versión de iOS también estaba en desarrollo. Casi ocho meses después llega a los primeros probadores de Android.

No es la primera vez que WhatsApp se acerca a la idea de «mensajes con hora». En 2025 ya probó los recordatorios personalizados para mensajes ya leídos en la beta de Android, una función que avisa solo a quien la configura. La programación de envíos es el paso lógico siguiente: pasar de recordarte que contestes a contestar por ti a la hora que elijas.

La escala ayuda a entender la prudencia, aunque esto es interpretación y no algo que Meta haya dicho. Mark Zuckerberg anunció en mayo de 2025 que WhatsApp tiene más de 3.000 millones de usuarios al mes. Con esa base, cualquier función que mueva mensajes sin que el usuario esté delante tiene que funcionar a la primera.

Mi lectura es que la función está bien resuelta en lo que se ve: el gesto es el estándar del sector, los límites son razonables y la regla de los grupos demuestra que alguien pensó en los casos incómodos. Lo que no se ve, cómo y dónde espera un mensaje cifrado mientras el teléfono está sin conexión, es justo lo que más interesa en una aplicación de mensajería cifrada.

Si WhatsApp acompaña el lanzamiento general con una explicación técnica de ese punto, esta será una mejora sin letra pequeña. Si no, quedará como otra función cómoda cuyo funcionamiento hay que dar por bueno.