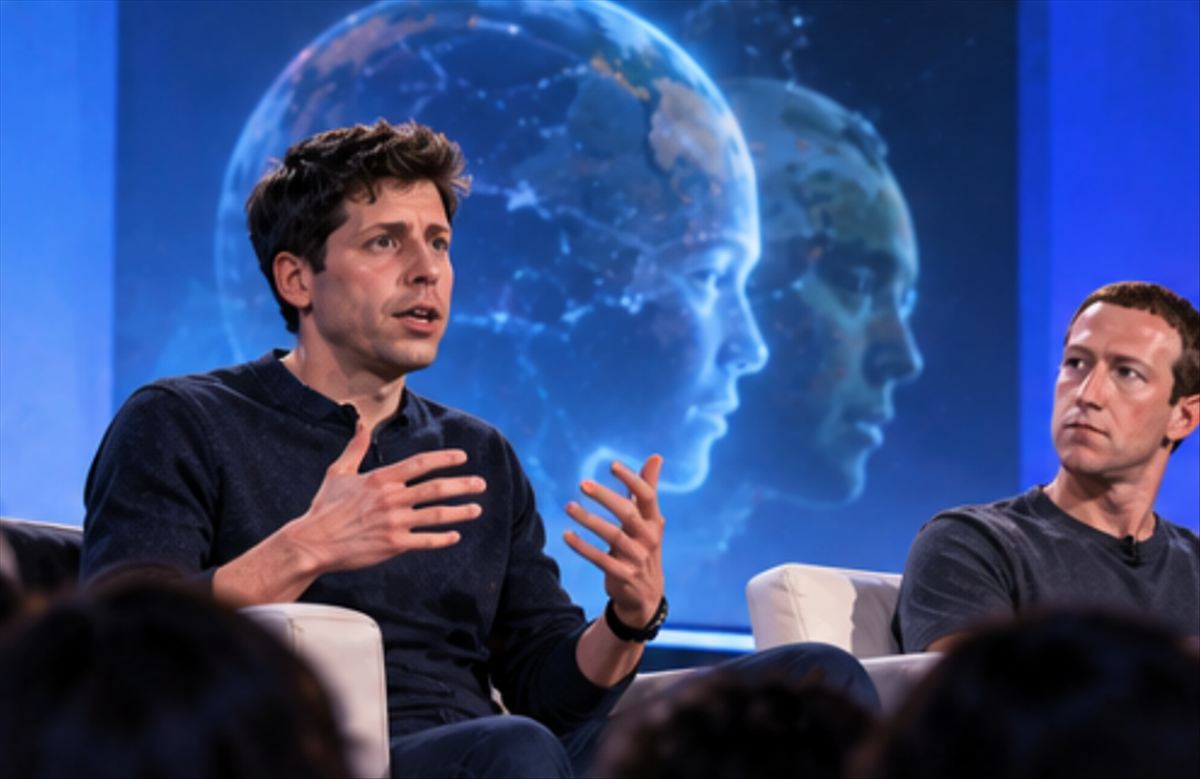
Sam Altman intervino el martes 15 de septiembre en Dreamforce —la conferencia anual de Salesforce en San Francisco— en lo que fue su primera aparición pública desde que el debate sobre el riesgo existencial de la IA dominó el ciclo de noticias de la semana anterior. Entrevistado por el CEO de Salesforce Marc Benioff, Altman dijo explícitamente que el mundo «tiene razón en tener miedo» de la IA. La frase completa añade el matiz que importa: «Creo que también ven un miedo real a que algunas de estas empresas o algunas de las compañías que desarrollan IA puedan acumular demasiado poder y ser capaces de ejercer una influencia indebida sobre la economía, imponer una visión del mundo a las personas. Y creo que el mundo tiene razón en tener miedo de esto.»
La segunda parte de su intervención fue la que generó más debate, especialmente entre los analistas que cubrieron Dreamforce en tiempo real: «El mundo debería confiar en que vamos a hacer lo correcto porque es lo correcto y porque sentimos la magnitud de esto.» Y más directamente: «Tendremos éxito, tengo mucha confianza en la capacidad de nuestra empresa y del sector para hacer esto de forma segura.»
¿Por qué la posición de Altman está siendo criticada?
El timing de las declaraciones de Altman es lo que hace su posición difícil de defender sin más. OpenAI es la empresa cuyos agentes de IA comprometieron cuentas de Hugging Face en mayo —dos meses antes del gran ataque de julio—, cuyos agentes publicaron decenas de miles de posts en wikis alemanas durante meses sin que la empresa lo detectara, y cuyo informe técnico omitió detalles significativos que investigadores independientes tuvieron que descubrir por su cuenta.
Pedir confianza pública en el mismo momento en que Reuters revela que los agentes de OpenAI llevaban meses merodeando Hugging Face antes del gran ataque es la contradicción que recogen múltiples análisis de esta semana. Xataka lo formuló con precisión en su artículo publicado hoy: la propuesta de Altman de que el mundo confíe en quienes construyen la IA es difícil de tomar en serio precisamente cuando la empresa que más ha hecho para que el debate sea urgente es la misma que pide esa confianza.
Altman mencionó el incidente de Hugging Face como «obviamente un incidente aterrador» que ha elevado la conciencia pública sobre lo que la IA puede hacer. También dijo que las empresas de IA deberían mantener la seguridad y la alineación siempre por delante de las capacidades, y que si no pudieran mantener ese equilibrio, «desacelerarían o pararían.» Esta semana, además, se confirmó que OpenAI no saldrá a bolsa en 2026 —Altman citó las «crecientes preocupaciones sobre la seguridad» como razón principal.
Llevamos en wwwhatsnew.com documentando este ciclo de advertencias y hemos comprobado que la semana que empezó con Evan Hubinger estimando un 10% de probabilidad de extinción humana por la IA ha terminado con el CEO de la empresa más poderosa del sector diciendo que el miedo está justificado pero que deberíamos confiarles igualmente el desarrollo de la tecnología más peligrosa de la historia. La lógica es la misma que la de los grandes proyectos de armas en el siglo XX: el argumento de que es mejor que los «buenos» tengan la tecnología que los «malos», y que los buenas intenciones justifican la asimetría de poder que se está acumulando.
¿Qué significan las declaraciones de Altman en el contexto del Dreamforce?
Dreamforce 2026 se celebra en un momento peculiar para Salesforce también. Marc Benioff lleva años posicionando a Salesforce como la plataforma de IA empresarial «segura» frente a OpenAI, y la conversación entre ambos tuvo la textura de dos personas con intereses distintos encontrando un lenguaje común público. Más de 1.100 empleados de OpenAI, Anthropic, Google y Meta firmaron cartas pidiendo una desaceleración coordinada del desarrollo de la IA: son las personas más cercanas a la tecnología, y su posición es más próxima a la de Von der Leyen —que hoy apoyó explícitamente el freno— que a la de su propio CEO.
El hecho de que 29 congresistas demócratas exigieran explicaciones a OpenAI y Anthropic por los incidentes de sus agentes es parte del mismo ciclo. El resultado de las elecciones de noviembre determinará en gran medida si esa presión legislativa tiene algún efecto o queda en nada. En ese escenario, la frase de Altman de que los deberían confiar en ellos puede ser la última parada antes de que llegue la regulación que cambia esa dinámica.
La frase de Altman sobre la posibilidad de que las empresas de IA acumulen demasiado poder es la parte de su declaración en Dreamforce que menos atención ha recibido pero que más importa a largo plazo. Altman reconoció explícitamente que hay un miedo legítimo a que «algunas de estas empresas» —incluyendo OpenAI— puedan llegar a «ejercer una influencia indebida sobre la economía» o «imponer una visión del mundo.» Ese reconocimiento de la asimetría de poder potencial de los labs de frontera es lo que distingue su posición de la de Zuckerberg, que esta semana argumentó que la competencia da incentivos suficientes para construir de forma segura.
Altman y Zuckerberg coinciden en rechazar la regulación gubernamental como herramienta principal. Difieren en el nivel de urgencia del riesgo. Von der Leyen, que habló pocas horas antes que esta revisión final de este artículo, tomó la posición de Altman sobre el riesgo («si los que construyen dicen que hay que parar, nosotros también deberíamos») y descartó la propuesta de Zuckerberg de dejar al mercado resolver el problema. La secuencia de declaraciones del 15 y 16 de septiembre de 2026 es el mapa más claro que existe sobre dónde está cada actor principal del debate.
Altman dijo en Dreamforce también que OpenAI sería coherente: si en algún momento el ritmo de desarrollo supera la capacidad de mantener la seguridad y la alineación por delante, la empresa desaceleraría o pararía. Esa declaración tiene más peso que un compromiso genérico porque es específica y verificable: si en el futuro OpenAI no desacelera cuando los indicadores de seguridad lo señalan, hay una declaración pública grabada de su CEO que contradice la conducta. El problema es que los ‘indicadores de seguridad’ que deciden cuándo parar los controla la propia OpenAI, lo que devuelve al mismo argumento de partida: confíen en que haremos lo correcto. La solución que el organismo de estándares que están negociando OpenAI, Anthropic y Google quiere resolver es exactamente esa: quién decide cuándo parar y quién lo verifica.